LangChain a ouvert la bêta publique de LangSmith Tool Gateway le 19 novembre. Une équipe enregistre des serveurs du Model Context Protocol, ou MCP, connecte les comptes qu’ils attendent et expose une sélection d’outils à un agent par une passerelle commune. Le service peut appliquer des politiques d’appel, demander une confirmation et enregistrer des métadonnées sur les résultats. Il est proposé sur LangSmith Cloud Plus et Enterprise dans les régions Google Cloud des États-Unis, d’Europe et d’Asie-Pacifique indiquées et sur AWS aux États-Unis. La documentation exclut la région Azure US. Ces conditions ont chacune un effet sur l’intégration à un déploiement existant. Annonce de LangChain · Disponibilité de Tool Gateway
Un exemple d’assistance permet de comprendre le changement. Un employé demande au service de retrouver un ticket ouvert. Une tâche planifiée vérifie aussi les tickets dont le délai de réponse est dépassé. Les deux peuvent joindre la même application. Les droits de l’employé doivent suivre son compte personnel, et la tâche a besoin d’une identité distincte, assortie de responsabilités précises. Les relier au même registre permet de mieux voir ce que chaque flux utilise. Cela rend aussi la configuration centrale plus importante. S’il devient difficile de distinguer la personne à l’origine du flux du compte qui touche un dossier, la passerelle peut répandre cette ambiguïté entre plusieurs équipes.
Un point de connexion commun change l’exploitation#
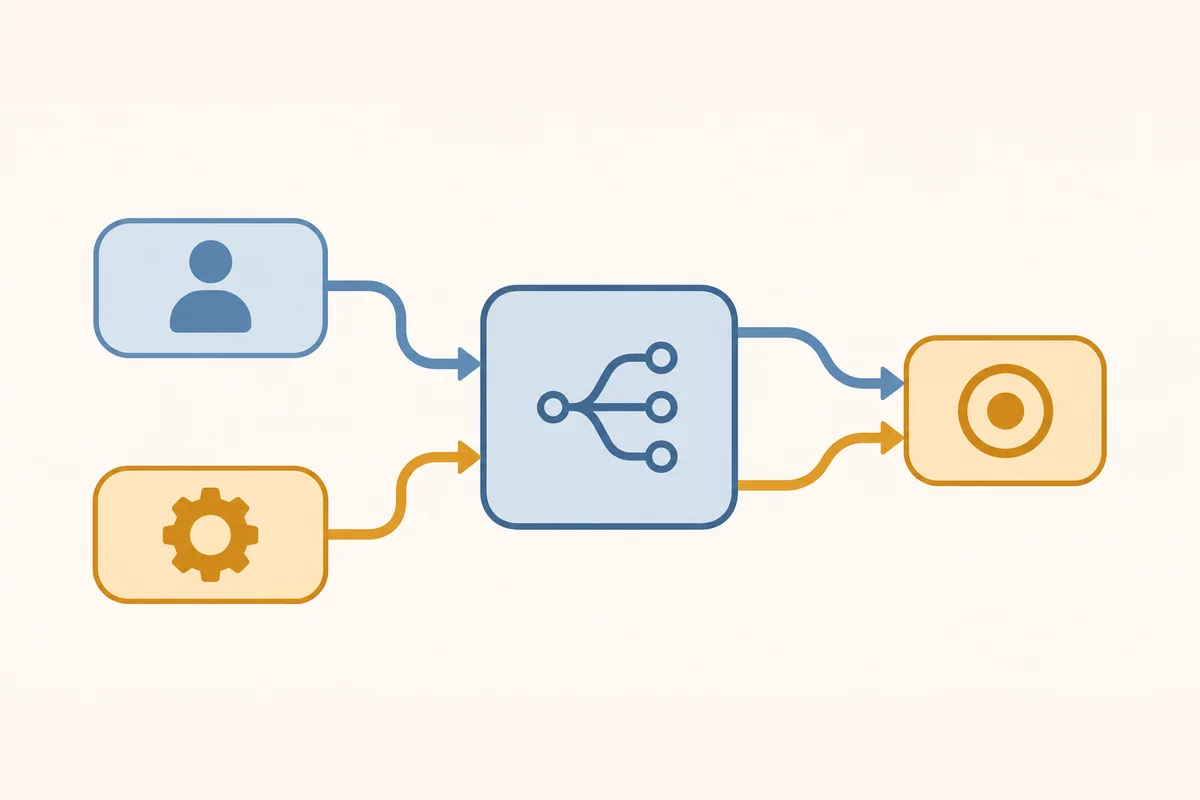
La fonction se place entre un client MCP et des serveurs MCP distants. Le protocole permet au client de découvrir la description d’outils et de demander à un serveur de les appeler avec des arguments structurés. LangSmith réunit dans un kit les outils issus de plusieurs serveurs. Le client utilise une adresse unique et le kit peut exposer une sélection plus étroite que les inventaires des serveurs. LangChain propose des connexions intégrées pour Google, Microsoft ou GitHub et accepte des serveurs distants enregistrés. Un compte configuré peut être réutilisé pour le même appelant et le même serveur. Plusieurs applications qui utilisent un service commun peuvent ainsi éviter du travail en double. Architecture et périmètre de LangSmith
Connecter une application et gérer les versions des outils sont deux responsabilités. Une équipe plateforme peut confier l’enregistrement des serveurs à une personne et le choix des outils d’un flux à une autre. Une modification apportée à un serveur enregistré peut toucher plusieurs clients. Renommer un outil, modifier les champs qu’il accepte ou renouveler un identifiant peut se faire sentir dans plusieurs applications le même après-midi. Un inventaire utile indique pour chaque serveur et kit un responsable, la liste des flux dépendants et la version ou l’historique des changements. La passerelle allège le travail dans les clients et crée un point commun dont il faut comprendre les changements avant qu’ils arrivent aux applications.
Le mode recherche peut aider quand un kit compte beaucoup d’outils. Le client cherche une liste pertinente pour la tâche au lieu de charger toutes les descriptions dans son contexte initial. Une liste plus courte peut réduire la taille de l’entrée et faciliter la distinction entre des actions similaires. La recherche constitue elle-même une étape du flux. Les équipes peuvent mesurer séparément la découverte et l’exécution, puis observer combien de fois une action raisonnable reste invisible à cause de son nom ou de sa description. Un kit de deux outils et un autre de mille appellent des évaluations différentes. Le résultat dépend de la manière de définir et de sélectionner les outils, ainsi que de leur publication. Architecture de Tool Gateway et recherche
Des noms ambigus montrent l’enjeu. Une application peut proposer une action pour préparer une réponse et une autre pour l’envoyer. Les deux paraissent pertinentes si un employé veut de l’aide pour traiter le même message. Un kit peut proposer la préparation dans le flux de rédaction et laisser une règle d’accès explicite encadrer l’envoi. Les noms et les descriptions guident la sélection. Les droits du service et la politique de la passerelle gouvernent l’exécution. Cette répartition permet d’éviter autant que possible l’ambiguïté tout en sachant ce qui arrivera si l’application sélectionne une autre action.
Suivre l’identité jusqu’à l’application#
Un appel comporte normalement deux étapes d’authentification. Le client prouve son identité à la passerelle. Celle-ci présente ensuite le moyen d’authentification attendu par le serveur MCP choisi. LangSmith peut choisir un identifiant connecté par un utilisateur, un identifiant attaché à l’environnement d’un agent ou un identifiant conservé dans un profil partagé. Il accepte aussi un identifiant d’espace de travail pour certains serveurs à clé d’API. Un serveur public peut se passer d’authentification en aval. Le compte qui appelle la passerelle et le compte que le service reconnaît peuvent donc être différents. Pour examiner une écriture, il faut connaître les deux. Documentation sur la connexion des comptes
Dans une application interactive, la délégation du compte du lecteur ou de l’employé peut conserver les droits que la destination attribue à la personne. Un système comptable peut déjà réserver certains livres à chaque équipe. La passerelle peut s’appuyer sur ces règles si l’application reçoit et contrôle le bon identifiant. Au premier usage, la passerelle peut demander à l’utilisateur de connecter son compte sur le service avant de poursuivre. Le développeur doit vérifier l’expérience d’un compte non connecté, d’une autorisation expirée et d’une personne dont les permissions ont changé. La connexion et l’action métier sont deux événements distincts, surtout lorsqu’une nouvelle tentative peut créer un enregistrement.
Une tâche en arrière-plan dotée d’une identité de service cesse de dépendre de l’employé qui l’a configurée. Il devient possible de gérer au même endroit les droits, la rotation du secret et le départ de cette personne. Un profil peut partager des identifiants entre plusieurs flux. Le gain est concret lorsqu’ils servent le même besoin et que les responsables comprennent ce partage. Un retrait d’autorisation, une permission mal réglée ou une rotation a aussi plus de conséquences. La question d’ingénierie consiste à choisir quand le partage correspond à des responsabilités communes. Les environnements qui effectuent des tâches différentes ou touchent des données distinctes ont besoin de comptes séparés. Agir en tant qu’utilisateur ou agent
Les identifiants à l’échelle d’un espace de travail méritent une attention particulière. D’après la documentation, la configuration d’un tel identifiant supprime les moyens d’authentification que les autres profils, agents ou utilisateurs ont enregistrés pour ce serveur. Tant qu’il est configuré, aucun autre propriétaire ne peut en connecter. Le changement modifie tous les flux dépendants. Pour un service de recherche muni d’une clé unique à l’échelle de l’organisation, ce comportement peut être attendu. Pour une application qui attribue des droits d’après l’employé connecté, l’utilisation d’un compte commun change ce que la destination peut contrôler et enregistrer. Avant de le mettre en service, il faut identifier le propriétaire, les flux qui l’utilisent et la marche arrière prévue si le test infirme une hypothèse. Propriétaires des identifiants et comportement de l’espace de travail
Le fournisseur d’identité de l’entreprise constitue un autre maillon. LangChain décrit des options pour un service qui agit au nom d’un utilisateur ou un client qui utilise le jeton d’un fournisseur lié. La documentation indique qu’un appelant identifié uniquement par ce jeton peut atteindre les serveurs ou les kits de l’espace de travail, sous réserve des contrôles sur l’appel. Une équipe plateforme doit vérifier à qui ces jetons sont remis et quelles actions ces utilisateurs peuvent demander. Elle doit aussi vérifier les droits du compte sur le service de destination. La spécification d’autorisation MCP traite chaque jeton comme destiné à un destinataire particulier. Des identifiants distincts pour les deux étapes rendent cette limite vérifiable. Options d’identité de LangSmith · Considérations de sécurité MCP
Ces distinctions comptent pour l’assistance courante. Une application peut signaler une erreur d’identité avant la sélection du compte distant. La passerelle peut demander une autorisation manquante. Le service peut reconnaître le compte et refuser l’accès à un enregistrement particulier. Un rapport d’erreur utile indique à quelle étape le refus s’est produit. Réessayer une autorisation révoquée parce que le service a répondu par une erreur de droits fait perdre du temps et peut masquer une modification de configuration. Des comptes qui voient des enregistrements de test différents permettent de constater quels droits le service a vérifiés et ce que le client a expliqué. Une délégation utile conserve un accès cohérent lorsque le personnel, les rôles et les environnements changent.
La découverte des outils et la politique d’appel ont des rôles distincts#
Selon LangChain, le kit sélectionne les outils montrés à un agent. Les droits de l’appelant sont vérifiés séparément. Pour un appel autrement accessible, les politiques bloquent les appels correspondants ou demandent une approbation. Un blocage prime sur l’approbation. Un appel sans restriction correspondante est autorisé par défaut sous réserve des autres permissions. Les règles s’appliquent aux points d’entrée de la passerelle pris en charge. Une règle d’organisation peut couvrir plusieurs espaces. Une règle d’espace peut répondre au besoin d’un service ou d’une équipe. Les rôles chargés des modifications doivent correspondre au périmètre de leurs conséquences. Règles de politique de Tool Gateway
Un bon test découle de cette répartition. On peut commencer avec un outil qui lit un enregistrement synthétique et un autre qui fait une petite modification réversible dans un système de test. Il faut regarder quel outil est choisi, relever l’identité attendue et vérifier ce que la destination reçoit. Vérifier ensuite les mêmes opérations permises et bloquées par les entrées prises en charge dans ce déploiement. La sélection doit rendre l’expérience plus simple et la politique validée doit encadrer l’exécution avec constance. Un petit kit dans le tableau de bord ne répond pas à la question du déroulement de l’appel. Un test fiable va jusqu’à l’enregistrement de l’application et peut être rejoué après un changement de droits ou de serveur.
La passerelle agit sur les appels qui la traversent. Le périmètre plus large dépend du déploiement. Dans une organisation aux nombreuses intégrations, il est utile de distinguer les procédures qui passent par les identifiants gérés par la passerelle et celles qui relèvent d’autres systèmes autorisés. Une discussion publique sur les passerelles de modèles posait déjà cette question: un point commun est-il un endroit où transitent réellement les requêtes ? La même logique vaut ici. Lorsqu’une équipe transmet un rapport, le destinataire peut croire qu’il couvre tous les actes d’un agent. Les routes documentées, les droits limités des comptes de destination et les journaux de l’application précisent le périmètre. Le guide AWS sur MCP développe le même principe d’identité et de moindre privilège. Guide AWS pour la conception de la sécurité MCP
La politique d’outil et la politique sur les données ont également des effets distincts. Une organisation peut permettre à un agent d’assistance d’invoquer une recherche et laisser au service de décider quels dossiers ce compte peut ouvrir. Deux appels du même outil peuvent concerner des dossiers différents. L’approbation laisse quelqu’un examiner l’action, et le service reste chargé de faire appliquer ses permissions. Le fait de garder la responsabilité des données dans l’application évite de recopier un contexte métier changeant dans le catalogue. L’équipe plateforme peut alors examiner la décision de la passerelle et la protection du dossier par l’application.
La valeur d’une approbation dépend de sa présentation#
La documentation décrit une approbation par formulaire MCP. Un client compatible demande une confirmation à la personne qui appelle et peut montrer l’outil, le serveur, la règle et les arguments. L’examen par une autre personne ne figure pas dans ce flux de la bêta. Cette différence influe sur les cas d’usage. Une personne demandant de préparer un brouillon peut confirmer une opération importante dans le même client. Une tâche planifiée sans opérateur présent ne peut dépendre de la même interaction. Une validation à quatre yeux demande un circuit d’approbation avec un autre responsable, des permissions et une trace de la décision. Approbation dans Tool Gateway
La confirmation pose aussi une question d’information. Une demande de mise à jour est lisible sur un petit cas d’essai et difficile à comprendre si l’outil de production accepte une longue structure d’arguments. La personne doit comprendre ce qui changera, sous quel compte et avec quelles conséquences en cas de répétition. Il est utile de limiter les actions en écriture, de les décrire de manière stable et d’afficher le dossier cible ou l’effet attendu. Une application peut construire un aperçu à partir de ses propres données. L’utilisateur confirme alors une opération intelligible. Une suite de confirmations similaires pendant une journée chargée peut diminuer l’attention, même si chaque formulaire exige une réponse.
Le premier essai doit se faire sur le client et l’offre réellement utilisés. LangChain cite ses propres clients d’agents, Claude Code et Cursor, et s’appuie sur l’interface commune de MCP. Le comportement précis dépend de l’intégration, notamment l’affichage du formulaire et le traitement d’un échec. Le fournisseur invite aussi les clients qui souhaitent les blocages et les journaux d’audit à contacter son équipe. Une annonce et une fonction activée sur un compte apportent des preuves différentes. Il vaut mieux consigner les rôles, offres et régions disponibles avant de dépendre d’une règle dans un contexte important. Connexion des clients LangSmith · Annonce de la bêta
Ce qu’une trace permet d’établir#
LangSmith décrit deux façons d’enregistrer les appels à Tool Gateway. Avec le contexte approprié, l’appel apparaît sous l’exécution de l’agent qui l’a demandé. Un administrateur d’espace peut aussi activer un projet distinct qui recueille les appels de l’espace. Les traces regroupent des métadonnées comme l’outil, le serveur, l’identité, le statut et la durée. LangChain indique que la trace de la passerelle ne conserve ni les arguments ni le contenu de la réponse. Le volume de données enregistré diminue. Pour savoir ce qui a été envoyé ou modifié, l’enquête doit se tourner vers les journaux de l’application et vers le contenu que le client a choisi de recueillir. Traces et champs de Tool Gateway
Supposons qu’un employé signale la clôture inattendue d’un ticket. La trace peut indiquer l’heure, l’appel, le propriétaire de l’identifiant et le statut renvoyé. L’historique du service peut indiquer le ticket, le changement d’état et le compte vu par l’application. Le rapprochement est plus simple avec un identifiant d’événement ou de requête connu des deux côtés. C’est particulièrement utile en cas de dépassement de délai. Le délai indique que la réponse n’est pas arrivée à temps. Il reste à savoir si le service avait déjà exécuté la modification. La stratégie de nouvelle tentative doit tenir compte de l’action et vérifier l’état avant de répéter une écriture lorsque cela est possible.
La complétude des traces dépend aussi du chemin et de la configuration. LangChain distingue les conditions de rattachement à une exécution de l’activation des traces à l’échelle de l’espace. Il précise qu’un appel authentifié uniquement par jeton de fournisseur d’identité ne relève pas de la première méthode. Les journaux Enterprise ont des règles et un périmètre propres. Un exercice court permet de vérifier ces différences. On peut effectuer une lecture autorisée, un appel bloqué puis un appel échouant en aval et regarder les enregistrements et heures qu’un opérateur récupère. Il faut aussi examiner une identité de service qui fonctionne en l’absence d’un utilisateur. L’important est que les bonnes personnes trouvent les éléments attendus dans un incident réel. Couverture des traces et audit Enterprise
Les métadonnées demandent des précautions. Un identifiant de compte, un espace de travail et un nom d’outil révèlent parfois une activité interne sans contenir d’arguments ni de réponse. L’exécution de l’agent peut aussi être soumise à une autre politique de journalisation côté client. L’équipe plateforme doit définir qui peut consulter les traces, quels identifiants permettent de faire les rapprochements et combien de temps l’information reste utile. La protection des données engage toutes les couches qui enregistrent des informations. Inspecter le format de la passerelle ne dit pas tout sur les journaux du serveur ou les données envoyées par un agent à son projet d’observation. Une vérification avec les responsables des applications permet de comprendre l’ensemble des traces.
Pour quelles équipes la bêta peut être rentable#
Le cas le plus favorable est celui d’une équipe qui exploite déjà plusieurs clients MCP et doit reconnecter les mêmes services approuvés. Le registre partagé, la définition des propriétaires et un format de trace commun peuvent raccourcir l’intégration et donner aux responsables des politiques un lieu de travail commun. Les effets se mesurent. Combien de temps prend l’ajout d’un deuxième client ? Combien d’identifiants indépendants faut-il renouveler ? À quelle vitesse un opérateur retrouve-t-il le dossier en aval ? L’équipe peut mesurer ces éléments avant et après un déploiement limité. Son mode actuel d’intégration constitue la référence pertinente.
La passerelle ajoute une dépendance d’exploitation. Elle peut elle-même renvoyer des erreurs, et le service appelé a ses propres limites et défaillances. LangChain documente les limites de la bêta, dont une attente de 60 secondes pour le début de la réponse du serveur et des plafonds de requêtes. L’équipe peut mesurer une distribution réaliste des durées, les demandes de reconnexion et les erreurs en aval. Une tâche qui culmine à la même heure dans plusieurs équipes peut demander un autre ordonnancement qu’un poste utilisé à des moments irréguliers. Des indicateurs de santé distincts facilitent le diagnostic lorsque plusieurs clients subissent un problème en même temps. Limites de Tool Gateway
Pour un essai comparable, fixer l’outil appelé et la charge de test dans les deux configurations. Observer séparément les appels ordinaires et les plus lents. Le délai avant transmission par la passerelle et le temps de réponse de l’application peuvent avoir des causes différentes. Il faut mesurer à part l’attente d’une confirmation humaine. En la joignant à la latence de service, on peut passer à côté d’une régression. Pendant un exercice d’incident, partir d’une modification signalée et mesurer le temps nécessaire pour retrouver l’identité de la passerelle et le dossier de l’application. Dans les mêmes conditions, ces observations déterminent le coût du composant et la valeur des preuves qu’il fournit.
Un pilote limité peut montrer si les responsabilités deviennent plus claires. Confier une activité interactive à un compte délégué et un test planifié à une identité de service dédiée. Choisir où récupérer la trace et quel enregistrement métier consulter. Observer les actions réussies ou bloquées, la reconnexion, les changements de droits et la suite que le client propose à chaque personne. Effectuer ensuite un changement de configuration prévu et mesurer à quelle vitesse les responsables retrouvent tous les flux concernés. Les équipes qui répondent déjà à ces questions gagneront surtout en facilité d’exploitation. Les autres découvriront où préciser leurs contrôles. La bêta met à portée de main des preuves pour les appels qu’elle traite. Sa valeur vient de la possibilité de les comprendre dans les systèmes qui détiennent les données.