Le 19 novembre, OpenAI a décrit son système interne Performance Factory. Il utilise Codex pour examiner les alertes de performance, consigner les constats et proposer des modifications. Un ingénieur examine la proposition et décide de la fusion. Après le déploiement, un autre agent vérifie si la mesure concernée est revenue à la normale. Selon OpenAI, le premier flux a suivi plus de 1 700 enquêtes et identifié des causes dans plus de 600 cas en un peu plus de trois mois. Ces nombres décrivent l’activité d’un service interne. Ils ne mesurent pas le gain de vitesse de ChatGPT pour un utilisateur type. Compte rendu d’OpenAI sur Performance Factory
L’intérêt d’ingénierie tient au passage entre ces étapes. Une véritable alerte peut signaler un symptôme ou un changement de composition des requêtes. Un diagnostic plausible peut laisser une observation sans explication. Un correctif peut améliorer un graphique et rendre le programme plus difficile à maintenir, ou changer son comportement. Séparer ces questions permet de demander des preuves pour chacune. Cela montre aussi où se déplace le délai. Mener davantage d’enquêtes aide lorsque les informations obtenues sont assez précises pour décider quoi changer.
Commencer par la mesure qui a évolué#
OpenAI disposait de moyens de production avant ce flux. Les ingénieurs examinaient les métriques, journaux, traces, profils et le code, et avaient rassemblé plus de 30 outils de performance. Un problème récurrent était la latence jusqu’au premier token dans ChatGPT. Le choix et l’utilisation de ces outils sont entrés dans la méthode commune. Ce contexte aide à lire le volume annoncé. L’agent travaille sur des données d’observabilité existantes. Une équipe aux mesures hétérogènes et à l’historique de déploiement dispersé part d’autres conditions. Un agent peut explorer ce qui a été enregistré. Des horodatages ou limites de requêtes manquants laissent toujours des lacunes. Description du travail antérieur par OpenAI
Le service part d’une alerte, puis recherche le début de la variation. Une alerte peut survenir des minutes ou des heures après la première dégradation. Un déploiement lancé avant l’alerte mais après la dégradation est une explication moins convaincante que ne le suggère cet ordre apparent. Il faut savoir quand une requête a rencontré le service modifié. Un paramètre peut atteindre un groupe de clients en premier. Une dépendance peut changer sur un autre calendrier. Relever ces dates permet de tester les modifications pertinentes parmi tout ce qui se déroule en parallèle.
Une moyenne plus lente peut aussi résulter d’une autre composition de trafic. Supposons que 900 requêtes prennent normalement 100 millisecondes et 100 requêtes 600 millisecondes. La moyenne est de 150. Si l’heure suivante en compte 700 du premier groupe et 300 du second, elle monte à 250 sans que chaque type ait ralenti. Le service peut toujours sembler plus lent, surtout si davantage de personnes utilisent la fonction longue. Le remède peut différer d’une régression qui allonge les requêtes comparables. Il en va de même pour les chemins avec et sans cache, les tailles de demande ou les modèles différents. Guide de surveillance de Google SRE
Pour vérifier le mouvement, il est utile de décrire d’abord le groupe atteint. Il peut dépendre de l’entrée dans le produit, de l’appareil, de la région, de la requête ou du cache. Une comparaison est plus informative quand on connaît aussi le début et la fin du chronométrage. Le délai jusqu’à la première sortie, la durée complète et le traitement sur le serveur décrivent des parties différentes du même appel. Les conventions OpenTelemetry pour HTTP montrent comment définir ces limites. Une application peut choisir un autre périmètre si elle le précise. Il détermine si le graphique représente l’expérience de l’utilisateur ou une étape interne. Définitions des métriques HTTP OpenTelemetry
Même pour un groupe comparable, percentiles et moyennes racontent des choses différentes. Quelques requêtes peuvent prendre des secondes tandis que la plupart restent proches du niveau habituel. La médiane ne bouge guère et un percentile haut évolue fortement. Dans une petite population, la queue peut aussi varier par hasard. Un compte rendu utile joint au graphique le nombre de requêtes, la période et la mesure. Il peut indiquer si le cas apparaît dans un test externe ou seulement dans un service interne. On peut alors décider s’il s’agit d’un effet pour les lecteurs, d’une possibilité d’optimisation interne ou d’une mesure à mieux échantillonner.
Le système d’OpenAI conserve le contexte dans une tâche indépendante de la session. Un service distribue le travail prêt à l’étape suivante. Codex agit avec une identité de service, ce qui permet de limiter les permissions et d’attribuer ses actions. Lorsqu’une tâche attend une remarque de revue ou un déploiement, elle peut s’abonner à l’événement et redevenir disponible. Une enquête peut traverser une diffusion, une correction et une mesure ultérieure. Les éléments à conserver sont la métrique, le groupe et les preuves du changement. Un autre exécutant devrait les retrouver sans reconstituer la conversation. Flux de tâches et identité de service
Une seconde lecture doit essayer de réfuter la cause#
Quand un enquêteur trouve une modification plausible, un examen séparé peut demander ce que son hypothèse prévoit. Pour une option échelonnée, les requêtes exposées devraient se comporter différemment des requêtes semblables qui ne le sont pas. Si l’option est retirée pour une partie des utilisateurs, la mesure devrait réagir dans des conditions comparables. Un groupe inchangé ne démontre pas à lui seul la cause, puisque le trafic, les dépendances et l’heure peuvent différer. Le test apporte plus que deux repères voisins sur un graphique. La méthode ressemble à une analyse de déploiement canari. La comparaison compte autant que le modèle. Google SRE sur les déploiements canaris
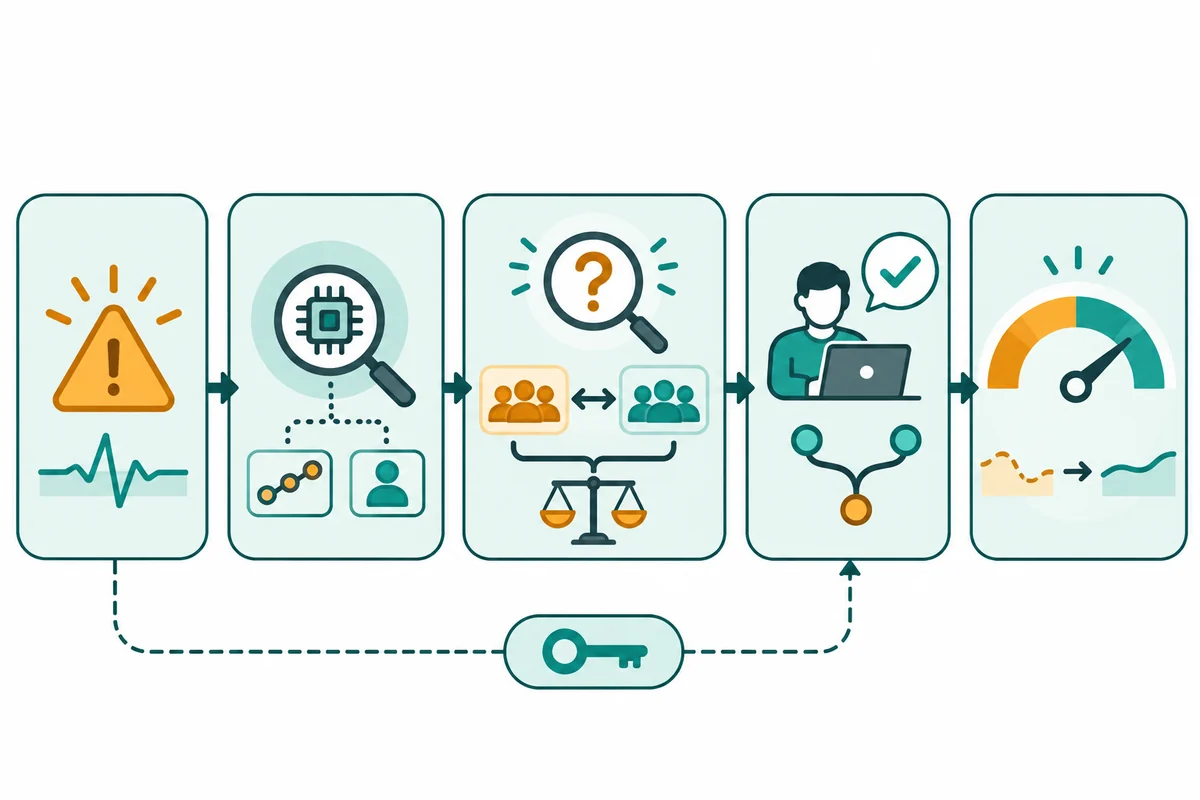
L’exemple d’OpenAI concerne le téléchargement d’images dans ChatGPT. L’enquêteur avait attribué des échecs de conversation à des erreurs d’accès aux images. La seconde lecture a vu que le service de localisation des fichiers avait récupéré pendant que les requêtes d’images échouaient encore. La proposition expliquait une partie de la chronologie et laissait la suite ouverte. La tâche a été renvoyée à l’enquête. Le second agent a besoin de mesures, d’un énoncé précis à vérifier et de la possibilité de laisser le dossier ouvert. Revoir le ton du résumé n’aurait pas comblé le manque de preuve. Exemple de contrôle du diagnostic
Une explication peut échouer de façons distinctes. Elle peut dater le début et accuser le mauvais déploiement, trouver le chemin sans expliquer l’ampleur ou expliquer la médiane tout en ratant la queue. On peut évaluer ces éléments séparément et conserver les parties établies. La personne suivante sait alors quelle question reprendre. C’est utile aussi pour l’évaluation ultérieure. Un seul score de dossier peut récompenser un récit plausible qui passe à côté de ce que les personnes subissaient.
Une seconde lecture indépendante répartit le travail autant qu’elle affirme un jugement. Deux agents utilisant le même modèle, les mêmes données et les mêmes instructions peuvent avoir des angles morts communs. Il est utile de donner au réviseur un objectif différent, comme trouver un groupe épargné ou lire le code de la bonne révision. Il peut indiquer la preuve qui changerait sa décision. L’ingénieur comprend alors les raisons d’accepter l’explication et ce qui reste incertain. Deux conclusions proches donnent moins d’information sur la qualité de l’examen.
Le coût d’un diagnostic erroné varie. Un mauvais diagnostic d’une petite alerte peut faire perdre du temps de lecture. Une modification d’une dépendance commune peut créer du travail pour plusieurs équipes et compliquer une panne ultérieure. Il est possible d’ajuster l’examen à l’impact attendu et d’indiquer si la décision est réversible. Réunir plus d’informations est parfois une issue valable. L’enregistrer évite qu’un tableau de bord traite tout dossier sans correctif comme une absence de travail.
OpenAI dit avoir jugé exactes 70 % des 100 causes proposées examinées manuellement. Les 30 % restantes demandaient un travail supplémentaire ou ne démontraient pas la causalité. Ce résultat porte sur un échantillon de propositions. Il est distinct des plus de 600 cas avec cause identifiée. Aucune des deux valeurs ne compte les correctifs déployés avec succès. Pour comparer des équipes, il faut tenir compte des incidents et du recrutement de l’échantillon. Le résultat publié laisse assez de questions en suspens pour comprendre l’intérêt de la seconde lecture. La méthode de sélection et les critères aideraient à interpréter le pourcentage. Évaluation manuelle selon OpenAI
Le correctif pose une autre question de qualité#
OpenAI dit qu’il était plus difficile de proposer une bonne correction que de trouver la cause. Des changements étaient trop complexes ou introduisaient de nouveaux problèmes. Le rapport donne l’exemple d’un cache qui accélère un chemin et peut laisser des données périmées. Une modification ciblée se vérifie contre une hypothèse. Un réaménagement large peut compliquer l’attribution du résultat et la reprise. Avant de lire le code, l’ingénieur doit savoir ce qui change, quelles preuves soutiennent le choix et ce qui peut arriver si la charge ou les données changent. La conception et l’exploitation se rejoignent sur ces questions. Examen des correctifs décrit par OpenAI
L’interface de revue doit garder les éléments qui influencent la décision. Une courbe du groupe avant et après une modification aide souvent davantage qu’une longue transcription des actions. Une trace situe une opération dans un service. Un profil CPU explique le temps pris par le code. Le compte rendu peut nommer la source, la période et la comparaison, puis pointer vers l’original. Si un élément manque, le lecteur doit voir la vérification absente et une étape possible. Cela évite de reprendre toute l’enquête avant de juger la proposition.
Les modifications les plus simples à vérifier ont un effet attendu sur une mesure et une manière de détecter les effets secondaires. Un test synthétique reproduit le comportement avec des entrées contrôlées. Un déploiement progressif vérifie l’effet sur la variété réelle. Pour le temps jusqu’au premier résultat, une étape interne accélérée compte si l’attente de l’utilisateur diminue aussi. On peut suivre les erreurs et le reste du temps de réponse, puisqu’un gain peut en masquer un autre. Réduire le CPU avec plus de mémoire peut déplacer une limite. La revue définit les résultats qui justifient le déploiement.
Le rapport explique que l’agent reprend après le déploiement effectué par un ingénieur. Le service compare le résultat au niveau d’origine. Un rétablissement complet clôt le cas. En cas de rétablissement partiel, il peut clôturer la première régression et ouvrir une tâche pour le ralentissement restant. Sans gain, l’enquête reprend. Plusieurs causes peuvent donc se retrouver dans une même alerte. Le point pratique est de conserver le même groupe et le niveau de référence pertinent. Si le service est moins sollicité au moment de vérifier, une courbe meilleure peut coexister avec un défaut encore présent par requête. Vérification après déploiement
Deux dates comptent dans une réparation. La première situe le changement de code. La seconde situe son activation sur le trafic concerné. Le seul horaire de fusion peut faire commencer l’essai trop tôt. Le trafic agrégé peut masquer les régions qui n’ont pas reçu la version. On peut consigner son identifiant et la fenêtre pendant laquelle elle a atteint le groupe. L’opérateur suivant compare l’attente au résultat et dispose d’un repère pour revenir en arrière ou poursuivre l’enquête si l’effet ne dure pas.
Une comparaison convenue d’avance compte quand deux changements arrivent presque ensemble. Le premier peut réduire la charge totale et faire disparaître un ralentissement temporaire. Le second peut diminuer le travail par requête. L’ordre et une mesure contrôlée aident à isoler les effets. Si l’on ne peut les séparer, le dossier peut constater leur simultanéité et dire ce qui reste incertain. C’est plus utile que d’attribuer chaque récupération à la dernière modification. L’équipe peut reconnaître une amélioration probable et identifier la mesure qu’il faudrait encore pour confirmer l’élimination de la cause.
Évaluer ce que l’agent pouvait savoir#
OpenAI décrit une réexécution d’incidents anciens pour évaluer le processus. Une nouvelle session reçoit l’alerte originale, sans le compte rendu ni les conclusions. Les tests historiques ont une difficulté. Les journaux et les traces expirent, tandis que des preuves ultérieures peuvent révéler la réponse. OpenAI limite les données de production consultables et examine la transcription pour détecter une réponse donnée trop tôt. L’évaluation doit retrouver ce qui était disponible au moment du choix et distinguer ce qui n’a été appris que plus tard. Évaluation d’incidents historiques d’OpenAI
Le résultat passé constitue une comparaison utile avec des limites. L’équipe historique a pu réduire un symptôme sans trouver toutes ses causes. Le modèle peut trouver une explication plus complète ou reprendre une version plausible. Noter séparément les dates, le groupe et les hypothèses laisse une place pour ces cas. Cela montre aussi si la nouvelle méthode aide certaines catégories et en dégrade d’autres. Il faut relever les preuves préservées, les versions et les accès. Essayer seulement sur les incidents qui ont servi au développement peut surestimer la valeur. Des cas nouveaux représentatifs apportent un contrôle supplémentaire.
OpenAI vérifie aussi les résumés sur des instantanés de tâches. On peut évaluer si un ingénieur extérieur au service comprend la panne, l’importance et la suite sans refaire le travail. Une tâche enregistrée et des liens stables rendent le test plus robuste. Il mesure un coût réel. Les responsables doivent choisir ce qu’ils lisent et ce qu’ils déploient. Regrouper les incidents et les classer par impact aide à reconnaître le même problème dans trois canaux. Compter les enquêtes sans le temps de revue laisse de côté ce qui arrive à la livraison. Évaluation des transmissions et regroupement des alertes
Le test peut aussi inclure les défaillances de la chaîne d’outils. Une permission peut disparaître et une requête de tableau peut perdre une série. Le rapport reste plausible sans signaler le contrôle manquant. OpenAI explique rechercher les problèmes d’accès et d’outils récurrents et ouvrir des tâches pour les résoudre. Une équipe peut mesurer la fréquence de la lacune, son effet et le temps de reprise. Comme elle surveille sa latence, elle peut surveiller la capacité de l’enquête à effectuer ses vérifications. Une amélioration de la chaîne doit montrer que le contrôle fonctionne de nouveau.
Mesurer une décision et un rétablissement#
Une équipe peut essayer la méthode sur une alerte étroite avec un propriétaire, des traces fiables et un chemin de changement contrôlé. Un pilote utile mesure le temps jusqu’à une explication exploitable, jusqu’à une modification approuvée, le nombre de propositions rejetées ou corrigées et le rétablissement sur la même mesure. Il peut indiquer ce qui arrive aux cas non résolus et combien de résumés doivent être lus. La comparaison avec le flux actuel est plus instructive que le volume d’une autre entreprise. Le pilote peut rester petit avec des observations précises.
La comparaison peut inclure le travail des personnes. Si les enquêtes doublent en même temps que les propositions que quelqu’un doit refuser, l’information peut arriver plus tôt et le bon correctif plus tard. Il faut garder le nombre d’enquêtes avec le temps médian de décision, les corrections par les réviseurs et les cas où le diagnostic reste utile après rejet de la proposition. Ces résultats ont des valeurs distinctes. Ils aident à décider si l’automatisation doit ouvrir une enquête, préparer la preuve ou écrire sous conditions.
Le processus publié et les pistes futures ont des états différents. OpenAI explore la possibilité qu’un jour certains changements à faible risque soient livrés sans approbation humaine. Le processus décrit confie la revue et la décision à un ingénieur. La détection proactive sans alerte se développe aussi. Des mesures différentes seront nécessaires. Pour la livraison automatique, il faudra des preuves, une portée autorisée et une reprise. Pour la détection, il faudra distinguer les nouveaux incidents du bruit. Les résultats publics actuels concernent l’enquête sur les régressions et l’assistance aux ingénieurs pour vérifier leur résolution.
L’idée la plus transposable est d’attacher à chaque étape une question vérifiable. Les mêmes requêtes sont-elles devenues plus lentes ? La cause explique-t-elle tout l’intervalle ? Qu’est-ce que la modification peut changer sans dommage ? Le trafic exposé a-t-il récupéré après le déploiement ? Cette structure aide personnes et agents à se partager un dossier sans confondre les étapes. Le progrès suivant se jugera au nombre de décisions prises plus tôt avec un rétablissement vérifié, et à la clarté des traces dans les cas ouverts.