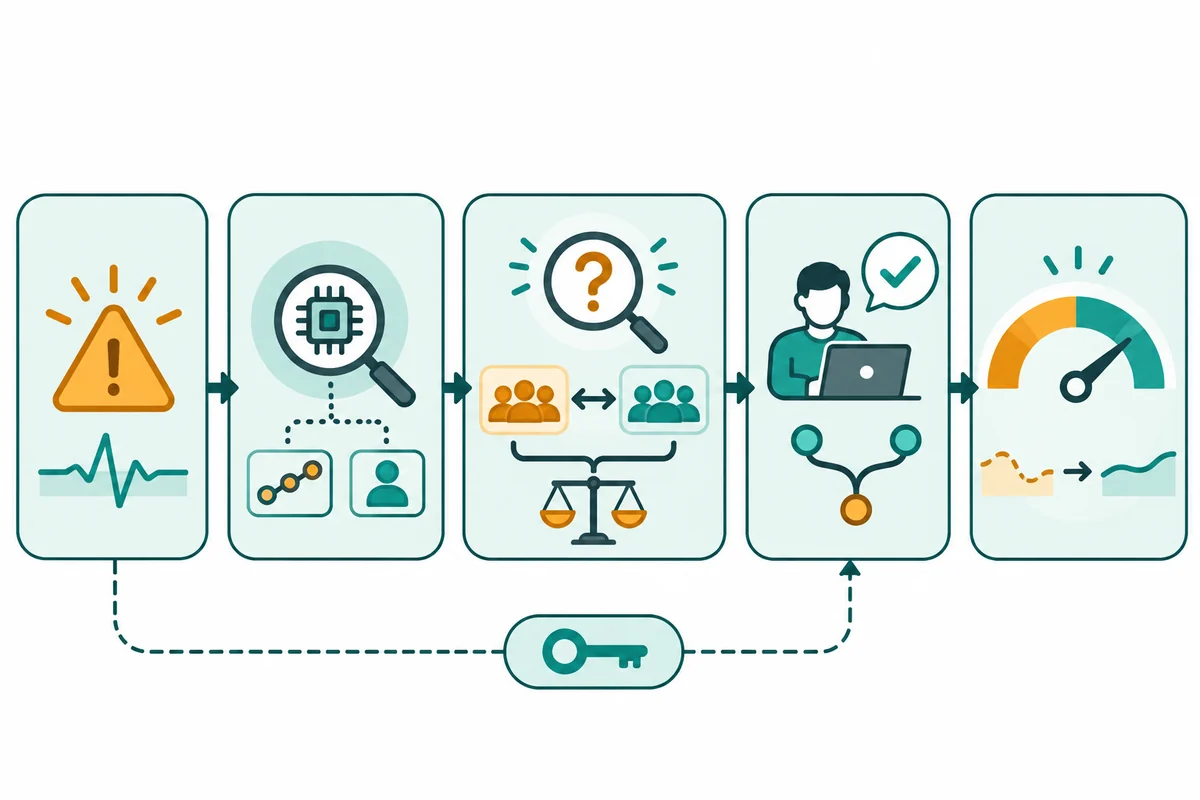
19 ноября OpenAI описала внутреннюю систему Performance Factory. Codex расследует предупреждения о падении производительности, записывает выводы и предлагает изменения. Инженер проверяет правку и решает, включать ли её. После развёртывания другой агент смотрит, восстановилась ли нужная метрика. По данным OpenAI, первый процесс отследил свыше 1 700 расследований и установил причины в более чем 600 случаях за три с небольшим месяца. Это объём работы определённой внутренней системы. Он не показывает, насколько ускорился ChatGPT для обычного пользователя. Отчёт OpenAI о Performance Factory
Инженерный интерес в переходах между этапами. Реальный сигнал может указывать на симптом или на изменение состава запросов. Правдоподобное объяснение может оставить значимое наблюдение без ответа. Исправление способно улучшить один график, усложнить сопровождение или изменить поведение. Разделение позволяет требовать доказательства для каждого вопроса. Оно также показывает, куда перемещается узкое место. Большее число расследований помогает, если выводы достаточно конкретны для решения, что менять.
Сначала нужно найти изменившийся показатель#
У OpenAI до этого процесса уже была рабочая система наблюдения. Специалисты вручную смотрели метрики, журналы, трассы, профили и код. Они накопили более 30 инструментов производительности. Одна повторяющаяся проблема касалась задержки до первого токена ChatGPT. Выбор и применение инструментов вошли в общую методику работы. Это важно для оценки пропускной способности. Агент работает поверх собранных данных. У команды с несогласованными метриками и разрозненной историей развёртывания другие исходные условия. Модель может искать то, что записано. Отсутствие временных отметок или границ запроса оставляет пробел в доказательствах. О прежней работе OpenAI
Сервис начинает с предупреждения и затем выясняет, когда началось изменение. Предупреждение может поступить через минуты или часы после первого ухудшения. Развёртывание до предупреждения, но после изменения, объясняет его хуже, чем кажется по простой последовательности. Нужно понять, когда затронутый запрос впервые пришёл в изменённую систему. Флаг функции может сначала действовать для части пользователей. У зависимости может быть собственный график обновления. По этим датам можно проверить изменения, имеющие отношение к возникновению эффекта.
Среднее время может вырасти из-за состава работы. Пусть 900 запросов обычно занимают 100 миллисекунд и 100 занимают 600. Среднее равно 150 миллисекундам. Если в следующий час пришло 700 запросов первого типа и 300 второго, среднее станет 250 без замедления внутри каждого типа. Пользователь может заметить проблему, если больше людей стали пользоваться медленной функцией. Исправление может отличаться от случая, когда одни и те же запросы стали обрабатываться дольше. Похожая ситуация возникает для запросов с кешем и без, разных размеров или разных моделей. Руководство Google SRE по мониторингу
Перед поиском причин полезно определить затронутую группу. Это может быть часть продукта, устройство, регион, тип запроса, состояние кеша или другая характеристика. Сравнение понятнее, когда также известна граница измерения. Время до первого результата, полное время и время обработки на сервере описывают разные части одного запроса. Соглашения OpenTelemetry для HTTP показывают, как обозначить начало и конец. У приложения может быть своя метрика, если определение известно. От границы зависит, показывает ли график ожидание пользователя или отдельный внутренний шаг. Определения метрик HTTP в OpenTelemetry
Даже для сравнимой группы процентили и средние способны расходиться. Несколько запросов могут ждать секунды, пока большинство остаётся у базового уровня. Медиана почти не изменится, а верхний процентиль сильно сдвинется. При малом числе запросов край распределения может быть шумным. В пригодном отчёте рядом с графиком видны число запросов, период и мера распределения. В нём можно указать, наблюдается ли случай внешним тестом или только внутри одного сервиса. Так легче отличить пользовательский эффект, возможность внутреннего ускорения и статистику, которой не хватает наблюдений.
OpenAI хранит контекст в задаче вне отдельной сессии. Служба распределяет работу для следующего этапа. По описанию компании, Codex использует сервисную учётную запись, чтобы ограничивать права и обозначать его действия. Пока задача ждёт замечания по коду или развёртывания, она может подписаться на событие и снова стать готовой после него. Расследование способно проходить через выкладку, правку и последующее измерение. Достаточно надолго сохранить метрику, группу и объясняющие переход доказательства. Следующему исполнителю нужно увидеть их без восстановления разговора. Задачи и сервисная учётная запись
При проверке нужно попытаться опровергнуть причину#
Если обнаружено правдоподобное изменение, проверяющий может спросить, что оно предсказывает. Если дело в флаге, запросы, получившие его, должны вести себя по-другому при сопоставлении с похожими запросами без флага. Если отключить его для части клиентов, метрика должна отреагировать при тех же условиях. Стабильность контрольной группы ещё не доказывает причину, поскольку меняются время, трафик и зависимости. Она даёт больше, чем два близких события на временной линии. Подход напоминает проверку ограниченного выпуска. Качество сравнения так же важно, как модель. Google SRE об ограниченных развёртываниях
В примере OpenAI речь шла о загрузках изображений ChatGPT. Агент связал сбои диалогов с ошибками доступа к картинкам. При следующей проверке выяснилось, что сервис поиска файлов уже восстановился, а запросы изображений всё ещё не работали. Причина объясняла часть периода, но оставляла последующий сбой. Задачу снова открыли для расследования. Второму агенту здесь нужны данные, конкретное утверждение для проверки и возможность оставить дело открытым. Исправление стиля резюме не восполнило бы причинный пробел. Пример перепроверки вывода OpenAI
Объяснение может ошибаться на отдельных этапах. Оно может точно указать начало и обвинить неверный выпуск. Может найти путь, но не объяснить силу эффекта. Может объяснить медиану и упустить большие задержки в верхнем хвосте. Процесс может оценивать аспекты по отдельности и сохранять доказанные части. Следующему участнику будет проще найти нерешённый вопрос. Это помогает и затем оценить сам процесс. Общая оценка способна наградить убедительный рассказ, даже если он не учитывает, с чем столкнулись пользователи.
Независимая проверка делит работу, а также оценивает вывод. Когда оба агента пользуются одинаковой моделью, данными и инструкциями, у них могут быть общие слепые зоны. Проверяющему можно дать другую цель, например найти незатронутую группу или прочитать код в нужной ревизии. Он может объяснить, какое свидетельство изменит решение. Инженер увидит основания принятия и оставшуюся неопределённость. Два похожих вывода сами по себе дают меньше информации о том, что именно проверялось.
Цена ошибочной причины бывает разной. Неверное объяснение краткого предупреждения может отнять время чтения. Исправление общей зависимости может затронуть несколько команд и осложнить следующий поиск. Для всех наблюдений не нужен одинаковый объём доказательств. Проверку можно соотнести с ожидаемым эффектом и указать, обратимо ли выбранное действие. Решение собрать больше данных тоже полезно. Запись такого результата мешает считать все дела без предложенной правки пустой работой.
Компания говорит, что в ручной проверке 100 предложенных причин 70 % получили оценку точных. Остальные 30 % требовали доработки или недостаточно устанавливали причинность. Это выборка предложений. Она отличается от более 600 случаев с установленной причиной. Ни один показатель не даёт числа безопасно развёрнутых исправлений. Для сравнения команд важны состав случаев и отбор. Публикация показывает, что нерешённых вопросов хватало для отдельной скептической проверки. Методы отбора, оценки и сравнения помогли бы толковать процент. Ручная оценка OpenAI
У правки есть отдельное требование к качеству#
По словам OpenAI, предложить подходящее исправление сложнее, чем найти причину. Некоторые правки слишком усложняли код или создавали новые проблемы. В отчёте приведён пример кеша, который ускоряет частый путь и способен оставлять устаревшие сведения при изменении данных. Узкую правку можно проверить по гипотезе. Более широкая переделка усложняет объяснение эффекта и возврат. До просмотра кода инженеру нужно знать, что меняется, какие доказательства есть и что произойдёт при смене трафика или данных. Эти вопросы относятся и к проектированию, и к эксплуатации. Как OpenAI проверяет исправления
При проверке нужно сохранить сведения, влияющие на решение. График затронутой группы до и после полезнее длинной стенограммы. Трасса локализует работу в сервисе, а профиль CPU показывает код, который занял время. Они отвечают на разные вопросы. В резюме можно отметить источник, срок и сопоставление, оставив ссылку на оригинал. Если данных нет, читатель должен увидеть пропущенный шаг и возможную следующую проверку. Инженер сможет решить, нужна ли правка, без полного восстановления чужого расследования.
Проще проверять изменение с ожидаемым эффектом на определённой метрике и способом увидеть побочные эффекты. Синтетический тест воспроизводит поведение с контролируемыми данными. Поэтапный выпуск показывает, сохраняется ли эффект на реальных запросах. Для первого вывода ускорение внутреннего участка важно, когда уменьшается и ожидание пользователя. Возможно, нужно смотреть ошибки и время остальной части ответа, потому что одна метрика может улучшиться за счёт другой. Снижение CPU с увеличением памяти способно перенести ограничение. Проверка определяет, какой общий результат оправдает выпуск.
По отчёту, система возобновляет работу после развёртывания инженером. Восстановление проверяют относительно прежнего уровня. Полное восстановление позволяет закрыть дело. При частичном можно закрыть исходную регрессию и открыть другую задачу для оставшегося замедления. Без улучшения дело возвращается к расследованию. Один сигнал может включать разные причины. Важно, какие базовый уровень и группа использованы в конце. Если общий сервис в это время загружен меньше, хороший график может совпасть с оставшимся дефектом отдельного запроса. Выборку и сравнение стоит держать в задаче. Описание проверки после выпуска
У исправления два значимых момента. Один показывает изменение в репозитории, другой действие правки на нужный трафик. Только время слияния может поставить начало проверки слишком рано. Только общий график может пропустить ещё не обновлённых пользователей и регионы. Инженер может указать версию и окно её появления у нужной группы. Следующий оператор сопоставит ожидание с фактом. Если эффект пропадёт, останется точка для возврата или расследования.
Согласованное сравнение особенно важно, когда две меры появляются рядом. Первая может уменьшить общую нагрузку и временно ускорить сторонний запрос. Вторая может сократить работу при каждом запросе. Порядок выпусков и контролируемый замер помогают разделить эффекты. Если полной изоляции нет, в задаче можно отметить одновременность и сохраняющееся сомнение. Так надёжнее, чем приписывать восстановление последней правке. Команда может реагировать на вероятное улучшение и знать, какое измерение нужно для вывода об устранении причины.
Оценивать надо то, что агент мог знать#
OpenAI описывает повтор прошлых случаев для проверки изменений процесса. Агент получает исходное предупреждение в новой сессии без отчёта и выводов. У исторической проверки есть трудность. Старые журналы истекают, а новые данные способны заранее показать ответ. OpenAI ограничивает чтение производственных данных и просматривает стенограммы на предмет подсказок. Для реалистичной оценки нужны сведения момента принятия решения и отдельная отметка того, что стало известно потом. Историческая оценка расследований OpenAI
У исторического итога есть собственные пределы. Команда могла смягчить симптом, не выяснив полную причину. Модель может предложить лучшее объяснение или угадать близкое. Отдельный подсчёт времени, группы и гипотез даёт способ учесть такие случаи. Он также покажет, улучшила ли новая версия один тип, ухудшив другой. Повторная проверка записывает доступные данные, модель, инструкции и границы доступа. Использование только тех случаев, по которым разработали процесс, способно преувеличить эффект. Нужны и репрезентативные новые дела.
OpenAI проверяет резюме отдельно на снимках задач. Можно узнать, поймёт ли новый инженер сбой, его значение и дальнейший шаг без повторного расследования. Стабильные ссылки и сохранённые задачи проще воспроизводить. При этом измеряется реальная трудоёмкость. Ответственные выбирают, что читать и выпускать. Группировка и сортировка событий помогают видеть одну проблему в нескольких источниках. Одно число выполненных расследований оставляет за рамками время проверки перед изменением. Оценка передачи и группировка сигналов OpenAI
Оценка включает и сбои самих средств. Смена прав может закрыть профиль. Запрос панели может перестать возвращать ряд. Агент способен написать гладкий отчёт, оставив проверку без внимания. OpenAI описывает поиск повторяющихся сбоев доступа и инструментов и создание задач на исправление. Команда может измерять частоту, влияние и время устранения пробела. Как она наблюдает задержку сервиса, так может наблюдать способность расследования сделать шаг. Улучшение диагностики должно показать, что раньше недоступная проверка снова выполняется.
Результат определяют по решению и восстановлению#
Команда может начать с узкого предупреждения, известных владельцев, надёжных трасс и управляемого выпуска. Полезный пилот измеряет время до пригодного объяснения и одобренного изменения, число отклонённых или изменённых предложений и восстановление на той же метрике. Он также показывает судьбу нерешённых инцидентов и число резюме, которые инженер прочитал. Сравнение с собственной практикой даёт больше, чем повторение объёма фирмы с другим трафиком. Небольшой пилот способен дать конкретные данные.
В сравнении важно учитывать людей. Удвоение расследований вместе с удвоением предложений, которые кто-то должен отклонить, может раньше показать проблемы и позже дать правильное исправление. Количество расследований следует держать рядом с медианным временем решения, исправлениями при проверке и случаями, когда инженер использовал вывод, но отложил предложенную правку. У этих результатов разные значения. Они показывают, где применять автоматизацию, к началу расследования, к подготовке доказательств или к написанию правки при оговорённых условиях.
Опубликованный процесс отделён от будущих исследований. OpenAI рассматривает, смогут ли некоторые изменения с малым риском в будущем выходить без одобрения человека. В описанном порядке инженер проверяет и решает, что выпускать. Поиск замедлений без сработавшего предупреждения тоже в разработке. Для этих вариантов нужны другие меры. Автоматический выпуск требует доказательств, прав и надёжного восстановления. Проактивный поиск должен отличать новые проблемы от шума. Пока опубликованный результат касается расследования и помощи инженерам в проверке результата.
Самая переносимая идея Performance Factory состоит в проверяемом вопросе на каждом шаге. Стали ли медленнее одни и те же запросы? Объясняет ли причина весь период? Что можно изменить без вреда? Восстановился ли целевой трафик после выпуска? Такая структура помогает людям и агентам работать над одним делом и понимать этап. Следующий полезный показатель расскажет, чаще ли команда принимает решение раньше и проверяет восстановление, сохраняя понятные записи о нерешённых случаях.